С 2012 года я начал сохранять цитаты из прочитанных книг. За четрынадцать лет у меня накопилось 342 заметки с цитатами из книг, всего чуть более 6 000 цитат. Больше половины — развёрнутые мысли, примерно каждая десятая — результат исследования или эксперимента, ещё столько же — диалоги. Немного статистики:
- Объём: 342 книги, около 6 000 цитат, примерно 490 тысяч слов. Это толстый роман в несколько томов, уровня «Войны и мира». Медианная цитата — 59 слов, то есть абзац, а не афоризм. 94% книг на русском.
- По годам: пик пришёлся на 2016–2017, это 2 000 цитат, треть всего архива. После 2020 года провал до 70–160 цитат в год, с 2024-го снова рост.
- Жанры: бизнес — 94 книги, психология — 47, фантастика — 44, научпоп — 43, художественная проза — 31, фэнтези — 20. Художественные книги — почти треть полки, но дают только 19% цитат.
- Больше всего цитат у Кара-Мурзы («Манипуляция сознанием», 87), истории психологии (85), Выготского (70), Вилкинсона про фасилитацию (69) и Харари (65).
- Темы: управление командой — 42, лидерство — 31, разработка ПО — 27, самопознание — 27, коммуникации — 19, когнитивные искажения — 15.
Вроде бы полезный багаж. Но с довольно неопределённым сценарием использования.
Регулярно перечитывать всё подряд казалось странной активностью. При этом идея «кладбища цитат», куда я аккуратно складываю чужую мудрость и больше никогда к ней не возвращаюсь, тоже не радовала.
Хотелось, чтобы эти записи иногда возвращались ко мне сами.
Случайная мысль из случайной книги
Давней навязчивой идеей была выдача случайных цитат. Одна мысль в день — или по запросу — чтобы вспомнить прочитанное, посмотреть на знакомую формулировку из сегодняшнего контекста или просто улыбнуться.
Какое-то время я даже проектировал мобильное приложение с таким функционалом.
До реализации дело так и не дошло.
В феврале этого года получилось навайбкодить получение случайных цитат из Notion, где тогда хранилась коллекция. А позже появился более подходящий способ превратить это в регулярный сценарий: Hermes Agent, живущий на сервере и общающийся со мной через Telegram.
О нём я рассказывал в предыдущем посте. Ви — вторая голова моего «второго мозга», доступная с телефона и способная выполнять задачи по расписанию.
Для утренней цитаты — практически идеальное место.
Но прежде нужно было разобраться с самими книгами.
Заодно переехать из Notion
К тому моменту я уже собирал «второй мозг» на базе Obsidian и Claude Code. Проекты, статьи, контакты и ежедневные заметки постепенно сходились в одном хранилище.
Оставлять книги отдельно в Notion становилось нелогично. Тем более что перенос давал возможность наконец привести накопленное за разные годы к единому формату.
За годы наполнения заметки несколько раз переезжали между платформами. Менялись сами приложения, их возможности и мои представления о том, как всё это лучше организовать. Где-то цитаты разделялись пустой строкой, где-то звёздочками, где-то минусами, где-то странными артефактами миграции между платформами. Отличались категории, теги, оформление и полнота сведений о книге.
Эту часть я поручил Claude Code — агенту, которому позже досталась личность Джуди Альварез.
Миграция заняла два дня, 19–20 мая. Каждая книга получила одинаковую структуру: название, автор, год прочтения, жанр, язык и тематические метки. Для жанров появился ограниченный набор значений, для тем — единые правила оформления. Книги разложили по тематическим коллекциям. Авторов унифицировали (Роберт Хайнлайн, Р. Хайнлайн и Robert Anson Heinlein стали одним автором).
Сами цитаты разделили простым Markdown-разделителем ---.
Коллекция стала обычными текстовыми файлами, с которыми могли работать оба агента.
Цитата дня
После этого случайная цитата оказалась совсем простой задачей.
Скрипт выбирает случайную книгу, затем случайную цитату внутри неё. Добавляет автора, название и год прочтения. Ви запускает его по расписанию и отправляет результат в Telegram.
Теперь каждое утро в 08:30 я получаю «цитату дня».
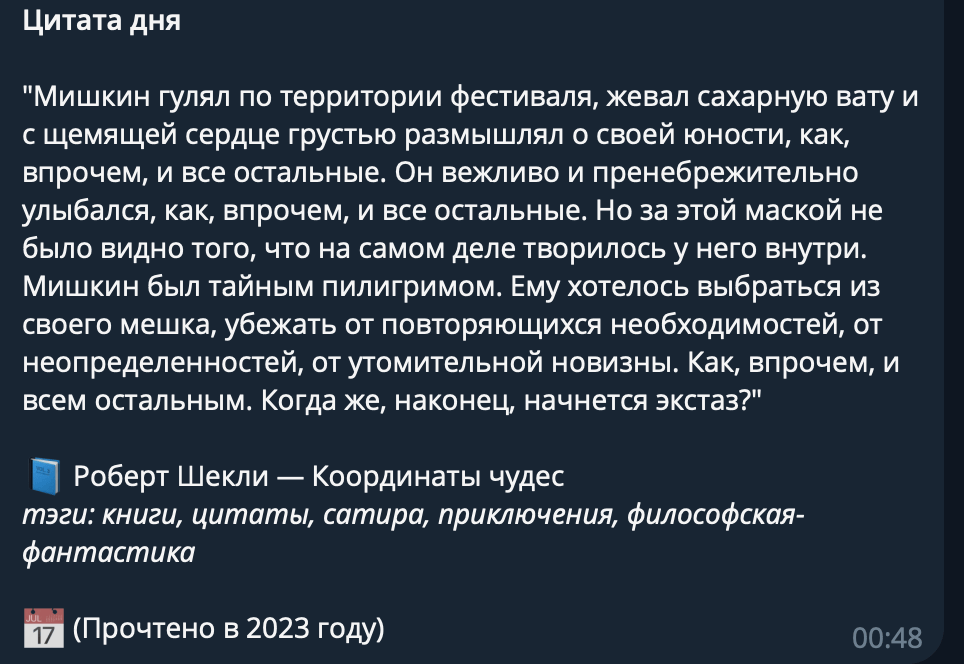
Выбор случайного файла и случайного блока выполняется скриптом. Агент сам его написал и встроил в свою систему доставки.
Это было первым полезным возвращением накопленного материала в повседневную жизнь.
Но оставалась другая потребность.
Поиск на заданную тему
Я часто использую эпиграфы в постах. Иногда нужна цитата к конкретной теме, иногда — к событиям месяца или настроению, которое хочется передать. Поиск по ключевым словам здесь работает плохо.
Если искать «саморазрушение», подходящая мысль вполне может оказаться в абзаце про зависимость, самообман или привычку оправдывать собственные поступки. Нужного слова там вообще не будет.
Тэги не помогают, потому что они про книги, а в рамках книги могут быть десятки цитат на разные темы.
Я вспомнил про такие штуки, как RAG и Embedding.
Откровенно говоря, на тот момент всё, что я знал об этих штуках — что они существуют, и что именно это должно мне помочь. Ладно, когда-то давно в рамках курса по Python и анализу данных я превращал фразы в вектора и искал похожие. Но это было давно. Как хорошо, что при наличии AI-ассистента обретение понимания можно совместить с формированием решения.
Немного технической части
Каждую цитату система отправляет модели эмбеддингов. Та превращает текст в вектор — набор чисел, который можно использовать для оценки смысловой близости текстов. Поисковый запрос преобразуется таким же способом, после чего система ищет близкие к нему векторы цитат. Этот механизм описан в документации эмбеддингов.
Для хранения индекса Ви использовала ChromaDB. Вместе с вектором сохраняются полный текст цитаты и сведения о книге, чтобы результат можно было сразу показать с автором и источником.
То есть в базе хранится векторное представление текста цитаты и сама цитата. Когда я задаю поиск вида «найди мне цитаты на тему Х», Ви отправляет «Х» модели эмбеддингов и превращает текстовое описание в вектор. Далее ищет похожие вектора в базе и выводит уже их текстовые описания.
Пример:
найди цитаты по теме «сохранение силы духа в условиях трудностей и невзгод»
— Психологическая статистика, — вставил Гирин, — отчетливо показала, что в трудных условиях жизни мужчины резко делятся на две группы. У одной возрастает стойкость и мужество, а у другой прогрессирует безответственность, стремление уйти от психологической нагрузки и заботы, переложив ее на плечи женщины или получая забвение в алкоголе.
📘 Ефремов — Лезвие бритвы
— Воспринимать трудности, неудачи и печали в жизни как вызов, принимая и парируя который мы становимся сильнее, а не как несправедливое наказание, которого мы не заслуживаем, — все это тоже требует веры и мужества.
📘 Эрих Фромм — Гуманистический психоанализ
— И в концлагере эта теория получила беспрецедентную проверку жизнью и подтверждение — наибольшие шансы выжить, по наблюдениям Франкла, имели не те, кто отличался наиболее крепким здоровьем, а те, кто отличался наиболее крепким духом, кто имел смысл, ради которого жить.
📘 Виктор Франкл — Сказать жизни — «Да» УПРЯМСТВО ДУХА
Неожиданная цензура
В процессе написания поста обнаружилась неприятная недокументированная деталь.
Эмбеддинг-модель от OpenAI text-embedding-3-small модерирует входящий текст.
То есть я отправляю сохранённую цитату, чтобы получить её числовое представление, а сервис может отказать из-за содержимого. Отказы получали конструкции вроде «следует умереть» или «пролил кровь», и даже выражения типа «убийственная жара», «жестокий рок».
При этом «он умер от старости», «казнить» и «пытки» проходили.
Из последней прочитанной книге по Warhammer 40k в поиск не попали восемь цитат, содержащих такие выражения. Половина заметки.
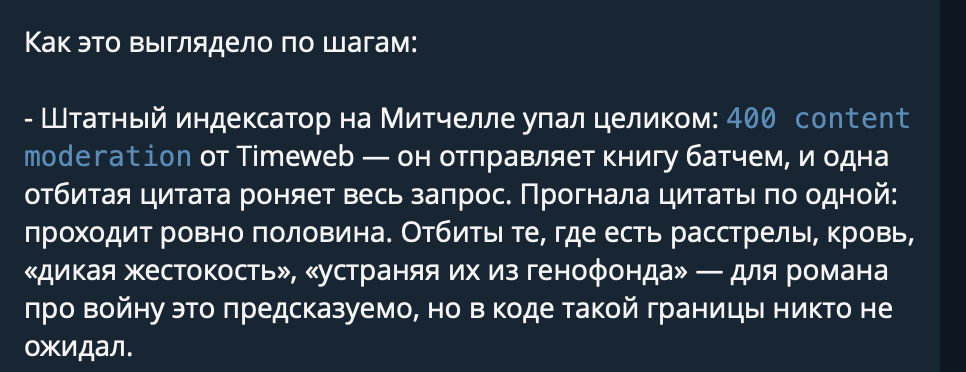
Ещё интереснее: цитата, сохранённая в индексе с июля, при повторной отправке в октябре уже получала отказ. То есть цензура внедрена недавно. И ещё интереснее, даже одни и те же цитаты или сгенерированные тексты иногда проходят, а иногда нет. Недетерминированное поведение — что может быть прекраснее.
Такой вот дополнительный редактор личной библиотеки.
Экстренно переехал на Qwen. Пришлось переиндексировать всю базу. Зато никакой модерации.
Что получилось
За много лет у меня накопился багаж мудрых мыслей, наблюдений и забавных диалогов. Долгое время основным действием с ним было «сохранить ещё одну цитату».
Теперь появились два способа возвращаться к сохранённому.
Одна цитата приходит сама каждое утро. Другие можно найти по теме. Пока писал пост, искал примеры, находил много интересного (а порой и странного) и залипал. В итоге пишу пост уже пятый час.
Для этого пригодились обе головы «второго мозга»: Джуди перенесла и упорядочила коллекцию, Ви организовала доставку и поиск.
Навязчивая идея, ради которой я когда-то проектировал отдельное приложение, наконец стала работающей частью повседневной системы. Без специального приложения.
И это оказалось только первым шагом полезного использования накопленного литературного контента. Но об этом в следующей серии.

