Где-то с начала этого года меня накрыло потоком рабочих активностей, потребностей, ожиданий и вопросов формата «а почему вот это ещё не сделано?». В роли технического продакта я был без малого полгода, но окружающих это волновало мало. При этом как истинный представитель переходного поколения X/Y, я считал, что должен разобраться, охватить всё и ничего не потерять.
Голова перестала справляться.
Не в каком-то метафорическом смысле. Каждый день записями покрывалась одна, две, иногда три страницы А4. Блокнот много лет был моим верным профессиональным инструментом, но в какой-то момент превратился в журнал входящих сообщений без поиска, фильтров и связей. На следующий день не всегда получалось вспомнить, к чему относится запись и зачем я вообще её сделал. А главное — блокнот не отвечал на простой управленческий вопрос: что прямо сейчас происходит по каждому проекту, какие там задачи, ожидания, решения и открытые вопросы?
Проектом, в данном случае, по заветам гуру тайм менеджмента начала 2000-х, я считаю любую комплексную активность, требующую координации и выполнения в несколько этапов. В какой-то момент их было 14 в параллели. Только рабочих. По каждому несколько открытых вопросов и ToDo-задач. А в рабочей памяти 7±2 объекта. Которые постоянно перезаполняются разным контекстом.
Примерно тогда мой дважды бывший коллега и хороший друг Женя предложил идею «второго мозга» на базе Obsidian и Claude Code: «Ты человек системный, тебе должно зайти».
На тот момент — это был апрель, хотя по ощущениям лет пять назад — предложение звучало довольно туманно. С нейросетями я был знаком на уровне веб-чатов. Obsidian представлялся чем-то про Markdown-файлы, странные связи между заметками и платную синхронизацию. После Evernote — трэш какой-то.
Но словосочетание «второй мозг» звучало привлекательно. Одного моего мне уже явно не хватало.
Вопреки принципам
Мой принцип в работе и жизни — сначала разобраться, потом делать. Но тут было понятно, что даже с Obsidian с его мириадами плагинов разбираться я могу несколько месяцев. А сколько уйдёт на выработку концепции того самого «второго мозга»?
Поэтому я пошёл против собственного принципа: установил Claude Desktop, открыл Claude Code и попросил помочь организовать мне second brain.
Исходный запрос не сохранился дословно. И точно не был похож на техническое задание человека, который уже знает, что такое skills, как должна работать память агента и где хранить его инструкции. Этого я тогда не знал.
После небольшого исследования на тему «что вообще такое этот „второй мозг“ на базе Obsidian» и нескольких уточнений запрос звучал примерно так:
Помоги построить персональный «второй мозг» на базе Obsidian и Claude Code.
Предложи минимальную рабочую структуру Obsidian, только необходимые плагины и несколько первых сценариев для Claude Code. Не пытайся сразу построить идеальную систему: сначала покажи план и задавай вопросы, если моих вводных недостаточно.
Дальше я в основном следовал предложениям Claude, проверял результат на своих задачах и говорил, что подходит, а что хочется изменить.
И — несколько неожиданно для меня — этого хватило.
Первая польза — ещё без агента
Claude предложил начать со структуры из четырёх типов информации:
projects— ограниченные во времени рабочие и личные проекты с конкретным результатом;areas— долгоживущие области ответственности и интересов: в моём случае AI, облачные платформы, айкидо и личное;resources— справочная информация, не привязанная к одному активному проекту;archive— всё, что потеряло актуальность, но может ещё пригодиться: завершённые проекты, старые материалы и черновики, уже ставшие постами.
От себя я добавил:
_inbox— единую точку для всего входящего и пока неструктурированного;daily— ежедневные, недельные и месячные отчёты для рефлексии и самоанализа;contacts— заметки о людях, встречах и контексте наших взаимодействий.
Только спустя несколько месяцев я узнал, что четыре базовые категории называются PARA: Projects, Areas, Resources, Archives. Но мне на тот момент просто было нужно место, куда можно выгрузить происходящее и потом найти его без археологической экспедиции по бумажному блокноту.
Следом Claude предложил шаблоны. Появились единые формы для проектов, контактов, daily, weekly и monthly отчётов. Вместо пустого текстового файла — заготовка с метадатой, нужными полями и разделами. При это, как выяснилось, Obsidian эти шаблоны превращает в очень даже привлекательно выглядящую разметку.
Из множества плагинов Obsidian для начала понадобились три. Это меня отдельно порадовало — люблю начинать с минимума, наращивая систему по мере осознанной необходимости.
- Templater — продвинутый шаблонизатор. Помимо обычной разметки подставляет данные на основе скриптов;
- Periodic Notes — обеспечивает ежедневные, недельные и месячные обзоры;
- Dataview — собирает данные из разных Markdown-файлов в одном месте.
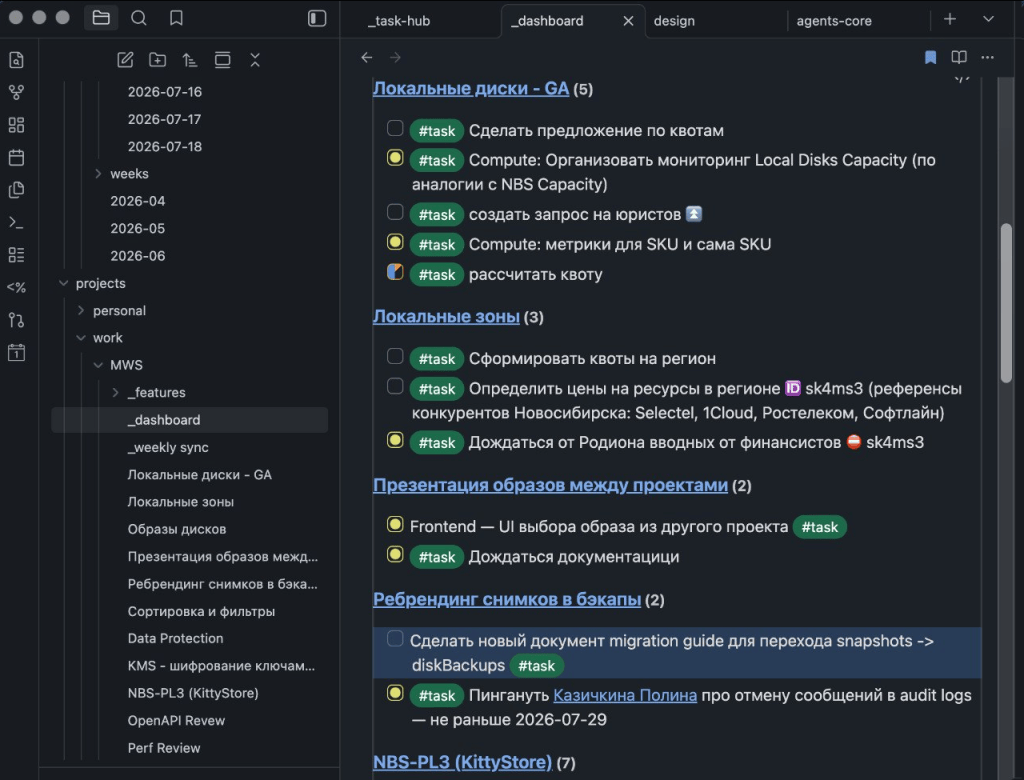
Первый дашборд собрался за вечер. Это обычная заметка, в ней нет ничего, кроме запроса Dataview: «покажи все пункты из блоков «Открытые вопросы» и «ToDo» всех проектов. Сгруппированные по проектам. Проекты сгруппируй по приоритетам»
Не четырнадцать файлов, которые надо по очереди открыть и вспомнить, что там происходило, а одна точка обзора всего масштаба работы. Можно увидеть самое горящее — и не продолбать менее горящее.
Это всё ещё просто текстовые Markdown-файлы, одинаковая структура заметок и запросы, которые умеют собирать нужные фрагменты. Но уже на этом этапе система делала то, чего не мог блокнот: показывала не историю записей, а актуальное состояние работы.
Один мозг на двух компьютерах
Довольно быстро возник следующий вопрос: рабочий ноутбук это хорошо, но некоторые вещи лучше делать на компьютере под Windows. И хотелось бы иметь единую систему с историей изменений и без конфликтов синхронизации, когда я случайно откорректирую один и тот же файл на разных компьютерах.
Для синхронизации я выбрал Git и приватный репозиторий на GitHub. На обоих компьютерах лежит локальная копия vault (vault — «хранилище» на языке Obsidian) , а плагин Obsidian Git автоматически забирает изменения и отправляет новые коммиты в репозиторий. Заодно Git позволяет откатить изменения, если что-то пошло не так.
Настройка потребовала немного возни с SSH-ключами, установкой Git на Windows и системным ssh-agent. Claude помогал траблшутить, так что всё прошло быстро и безболезненно. Редактировать конфиги самому не пришлось (хотя проверить, что он там понавписал стоит).
В этой конфигурации помимо заметок синхронизируются и плагины Obsidian вместе с настройками, а потом я и Claude попросил разместить в vault свою память и навыки (skills), чтобы не приходилось его переобучать на каждой платформе.
В итоге вместо платного сервиса синхронизации Obsidian я получил переносимость, историю изменений и независимость от одного приложения. С перспективой развёртывания и на Linux-платформах без GUI.
Вдыхаем во «второй мозг» жизнь
До этого момента Claude помогал мне строить систему, но сама система работала в основном средствами Obsidian. На этом этапе Claude Code получил постоянные инструкции по работе с vault.
В корне появился CLAUDE.md — обычный Markdown-файл, который Claude Code читает при старте сессии. В нём были описаны:
- структура vault и назначение каталогов;
- мой рабочий и личный контекст;
- форматы проектов, daily и контактов;
- правила изменения существующих заметок;
- несколько часто повторяющихся операций.
Первая версия была довольно компактной. Например, она знала, что при обновлении проекта нужно менять дату updated, добавлять запись в лог изменений и не удалять файлы без явной команды. Для разбора inbox она должна была предложить тип заметки, целевую папку и теги, а применять изменения — только после подтверждения.
Это не какая-то специальная база данных и не обучение собственной модели. CLAUDE.md — текстовая инструкция, которая каждый раз возвращает агенту контекст: кто я, как устроено моё хранилище и какие договорённости здесь действуют. Claude Code официально поддерживает такие проектные инструкции, хотя прямо предупреждает: это контекст для модели, а не технически неразрушимые ограничения. В чём довольно быстро довелось убедиться.
Постепенно многошаговые регулярные операции начали оформляться в skills — отдельные инструкции, которые Claude подгружает, когда узнаёт подходящий сценарий. В документации Claude Code skill — это папка с файлом SKILL.md, описывающим знание или рабочий процесс. Можно писать их самому, а можно попросить Claude сделать это самостоятельно по пожеланию в свободной форме.
Одним из первых таких skills у меня стал save-article. Я даже не изучал документацию на тот момент. Я просто попросил Claude «сделать скил сохранения важной информации из статьи — ключевых идей, что может быть нам полезно, и какие практические применения могут быть уже сейчас».
Новый сценарий позволял дать Claude ссылку, попросить выделить суть и практические идеи, подобрать место и связи в vault. Так можно было быстро сохранять полезные статьи, наполнять свежесозданную базу знаний и пополнять список идей, к которым стоит вернуться позже. Иногда даже не читая сами статьи. В отличие от сохранения страниц в закладки браузера, такие знания не оседают мёртвым грузом, а снабжаются связями и тегами, так что всплывают в сессии обсуждения с ИИ по близкой теме.
Накопление знаний с убеждением вспомнить их, когда они понадобятся — это прекрасно. Хотя эффект отложенный. А быстрая польза оказалась не в сохранении статей.
Она появилась, когда я перестал вручную обслуживать собственную систему.
Не вести проекты, а разговаривать о них
Первым шагом была выгрузка рабочих и личных проектов из головы. У каждого появилась заметка с контекстом, текущим состоянием, следующими действиями, открытыми вопросами и историей изменений. Само по себе это уже снизило нагрузку: больше не нужно было помнить всё одновременно.
Но четырнадцать проектов остаются четырнадцатью проектами, даже если разложить их по красивым файлам. Если каждый из них нужно регулярно открывать и вручную актуализировать, второй мозг быстро превращается во вторую работу.
Поэтому формат взаимодействия изменился.
Вместо «открыть проект A, найти статус, переписать два абзаца, перейти к проекту B» я время от времени говорил: «Давай пройдёмся по проектам и обновим статусы». Claude находил активные проекты, последовательно задавал вопросы и сам вносил согласованные изменения в нужные файлы.
После встречи можно было скинуть сырые записи или вообще транскрипт встречи (если получалось его организовать) со словами «обнови проект». Агент разбирал заметки, находил решения, задачи, открытые вопросы и изменения статуса, а затем раскладывал их по существующей структуре.
Это и стало для меня основным эффектом.
Я не передал агенту ответственность за проекты. Он не решает, что для меня важно, не договаривается со стейкхолдерами и не определяет следующий шаг без моих вводных. Но он снял значительную часть механической работы между «я узнал или решил что-то» и «система отражает актуальное состояние».
Если очень грубо, базовая структура закрыла процентов шестьдесят моих типовых сценариев того аврального периода. Самых рутинных и неинтересных. И для старта этого казалось более чем достаточно.
Входящие, следующие действия, регулярные обзоры — всё то, что в GTD приходится дисциплинированно делать руками, здесь делает агент. Получился GTD на стероидах.
А что именно здесь является «вторым мозгом»?
Словосочетание громкое и местами уже маркетинговое. В описанном виде система пока не воспроизводит человеческую ассоциативную память и не понимает меня мистическим образом. Более сложные уровни — семантический поиск, компиляция знаний, связи между концепциями и несколько взаимодействующих агентов — появились позже. Как и человеческий мозг, эта система требует накопления знаний и связей между ними для эффективной работы.
Но базовый набор уже делает три полезные вещи.
1. Хранит то, что не должна удерживать рабочая память
Статусы проектов, решения, обещания, вопросы, информация о людях и результаты встреч находятся в файлах, а не конкурируют за место в голове. Кроме того, я складываю впрок всё, что цепляет по «зонам интересов» — облачные платформы, ИИ-инструменты, справочные материалы и просто любопытное. Каждая заметка получает теги, перекрёстные ссылки и метаданные: чтобы потом машина смогла разобрать это и собрать в знания.
2. Собирает разрозненное в точки обзора
Dashboard показывает задачи и вопросы по всем проектам. Weekly sync восстанавливает рабочую неделю. Weekly и monthly заметки собирают материал из ежедневных отчётов для рефлексии. Не нужно помнить, где лежит каждая запись: система сама формирует нужный срез.
3. Снимает обслуживание самой системы
Claude Code разбирает входящие, обновляет проекты из сырых заметок, помогает проводить обзоры и сохраняет материалы по заданным правилам. Чем чаще повторяется операция, тем логичнее один раз оформить её как skill.
Именно сочетание этих трёх слоёв — хранения, обзора и действий — отличает мой второй мозг от просто большой папки с Markdown-файлами.
Насколько сложно повторить
Самая неприятная часть любого рассказа о персональной системе — автор показывает результат после нескольких месяцев развития, а читателю достаётся схема космического корабля и совет «начните с малого».
Поэтому важная оговорка: нынешняя структура моей системы гораздо сложнее той, с которой я начинал и которая тут описана (в том числе потому что черновику этой записи на момент последней правки без малого пять месяцев). В ней больше правил, skills, отдельных слоёв знаний и технических ограничений. А ещё с ней работают 3 ИИ-агента. Для получения первой пользы всё это не требуется.
На старте достаточно:
- описать Claude свою работу, личные области и регулярные ритуалы;
- попросить минимальную структуру;
- начать складывать реальные проекты и входящие;
- сделать одну точку обзора, которая решает сегодняшнюю боль;
- автоматизировать одну повторяемую операцию после того, как она действительно начала повторяться.
В моём случае первая архитектура не потребовала большой переделки. Были ошибки в шаблонах и сложности с настройкой, но они решались в ходе той же коммуникации с Claude Code. Я описывал симптом или показывал ошибку, агент искал причину и правил файлы.
Вывод простой: чтобы начать, нужно уметь описать собственную жизнь и работу. Всё остальное можно уточнять по дороге.
А самое трудное во всей истории оказалось вообще не про систему: оплатить Claude Code в РФ и обеспечить доступ приложению Claude Desktop к веб-ресурсам Anthropic.
Что получилось в итоге
Если свести первые месяцы к сценариям, а не папкам и плагинам, результат выглядит так:
- я вижу все рабочие проекты, TODO и открытые вопросы в одном dashboard;
- перед пятничным синком быстро восстанавливаю сделанное за неделю;
- регулярно собираю daily в weekly и monthly для рефлексии;
- храню рабочие и личные проекты в одной понятной системе;
- сохраняю полезные статьи не в кладбище вкладок, а в базу знаний и будущие идеи;
- скидываю сырые записи после (или вообще транскрипты) встреч и прошу обновить нужный проект(ы);
- время от времени прохожу по проектам вместе с агентом вместо ручного обслуживания каждого файла;
- получаю одну и ту же систему на рабочем ноутбуке и домашнем ПК — вместе с правилами, skills и собственной памятью Claude.
Так у меня появился не безошибочный цифровой двойник и не всезнающий ИИ. Появилась система, которая заметно меньше забывает, быстро восстанавливает контекст и берёт на себя значительную часть информационной рутины.
А дальше всё стало существенно интереснее.
Система росла и развивалась: автономный агент в Telegram, семантическая память, взаимодействие нескольких агентов и компилированный слой знаний, который не просто находит старые записи, а собирает из них устойчивые концепции и убеждения.
Но это уже следующие части истории.
 Self Engineering
